

2026.09.19
Apache Airflow:把数据与自动化流程写成可调度的工作流
Apache Airflow 适合用代码编排结构相对稳定的数据、机器学习和自动化流程。它功能丰富,但不适合直接承担流式处理或大规模数据传输,部署前还需评估运行平台、数据库和任务执行架构。
它解决什么问题
Apache Airflow 是一个以代码编写、调度和监控工作流的平台。团队可以把任务、依赖关系和执行逻辑组织成 DAG,由调度器安排任务在多个 worker 上运行,并通过界面观察流水线进度、定位失败和排查问题。工作流采用代码定义,也意味着它更容易纳入版本控制、测试和协作流程。
它尤其适合结构大体静态、变化较慢的流程:例如定时数据集成、ETL/ELT、报表准备,以及机器学习中的训练、再训练、评估和部署编排。官方 README 也提到,Airflow 正被用于协调代理和大语言模型工作负载中的数据准备、工具调用、模型调用与评估;但它负责的是流程编排,而不是充当代理本身。
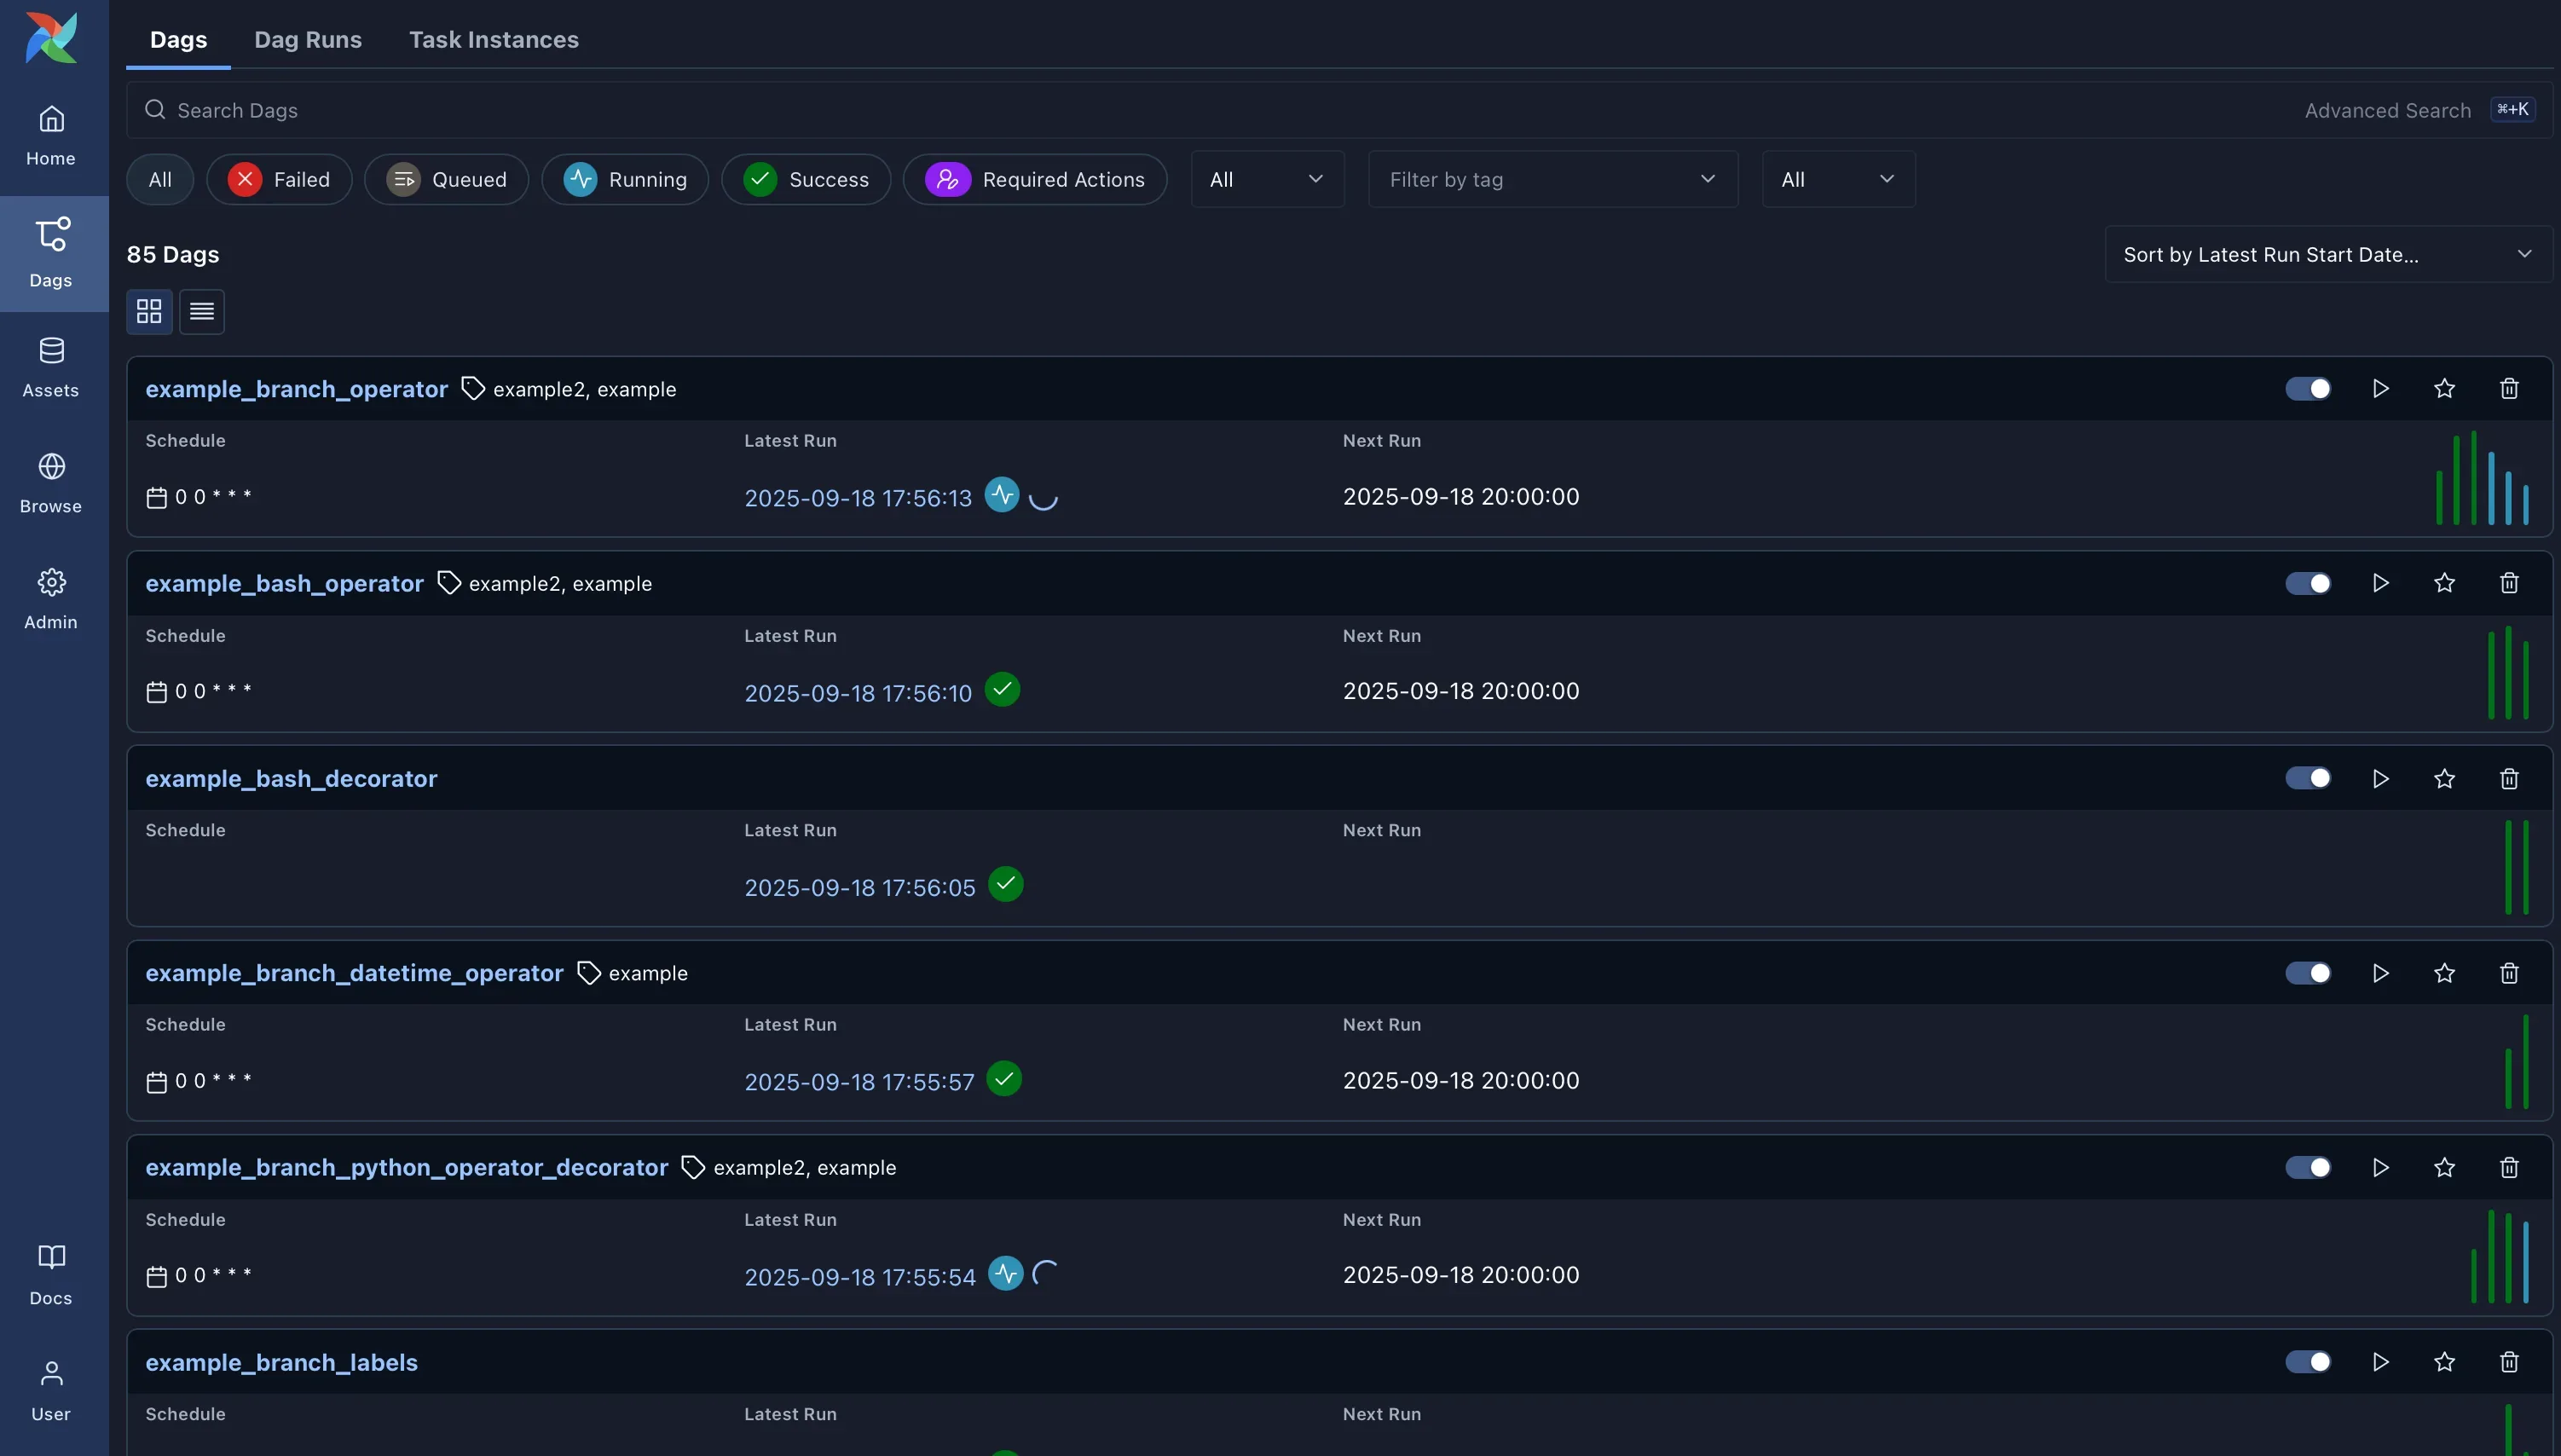
图片来源:airflow。项目公开截图,界面可能随版本变化。
已知功能与适合人群
Airflow 的 DAG 可以用代码动态生成和参数化,并可借助 Jinja 模板定制流程。项目提供一系列 operator,也允许扩展以连接不同系统。调度器负责遵循依赖关系执行任务,命令行工具和用户界面则分别覆盖运维操作、可视化和故障排查。
因此,它更适合已经有数据工程、平台工程或机器学习流水线需求,并愿意维护工作流代码、调度组件、执行节点和外部服务的团队。希望把少量脚本改造成可追踪、可重试、可协作流程的工程师,也可能从中受益;但需要接受它是一个平台,而非单一脚本运行器。
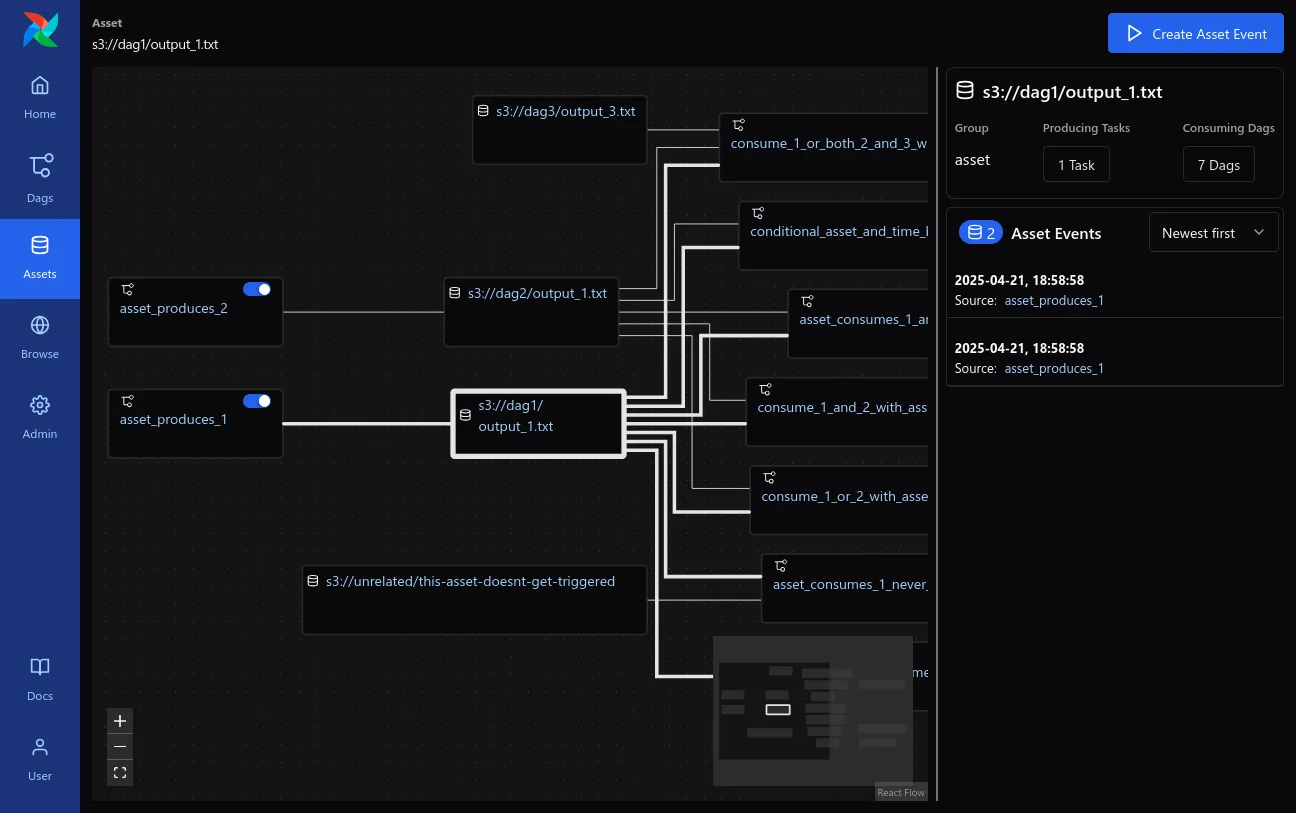
图片来源:airflow。项目公开截图,界面可能随版本变化。
采用前的限制
首先,Airflow 不是流式处理方案。它可以从实时数据流中按批次取数,却不应被当作持续低延迟流处理引擎。对于高吞吐、数据密集型任务,官方建议把实际工作交给专门的外部服务,而不是在任务之间搬运大量数据。任务也应尽量幂等,以减少重复执行带来的副作用;Airflow 的 XCom 更适合传递元数据,而非大数据集。
其次,工作流结构若频繁变化,DAG 的代码维护和调度语义需要额外设计。部署方面,官方说明生产执行环境应使用 Linux-based 发行版;Windows 运行路径是 WSL2 或 Linux 容器,不能据此推断原生 Windows 生产支持。README 列出 AMD64/ARM64、Python、Kubernetes、PostgreSQL、MySQL 等测试范围,但具体组合仍应结合目标版本和 provider 文档核对。SQLite 可用于测试和本地开发,官方明确不建议用于生产。
部署与升级考虑
采用前应先确定元数据数据库、任务执行方式、worker 扩展策略、凭据管理和日志留存方案,再根据工作负载选择本地、容器或 Kubernetes 部署。不要只看 DAG 编写体验,还要评估调度器、数据库和外部任务系统的运维责任。
项目仓库显示采用 Apache License 2.0,且未归档。3.3.2 正式版说明还记录了回填接口授权行为及显式凭据与会话 cookie 的优先级变化。升级时应阅读对应 release notes,检查 API 客户端、认证流程和审计行为,避免把版本升级当成无影响的替换。
资料来源
资料核对日期:2026-09-19